14. Atenção: os três passos
Vamos ver as contas com um exemplo minúsculo: 2 tokens ('a' e 'b'), vetores de
tamanho 2. Suponha que já saíram estes Q, K, V:
Token 'a':   Q = [2, 0]    K = [1, 0]    V = [10,  0]
Token 'b':   Q = [0, 2]    K = [0, 1]    V = [ 0, 10]
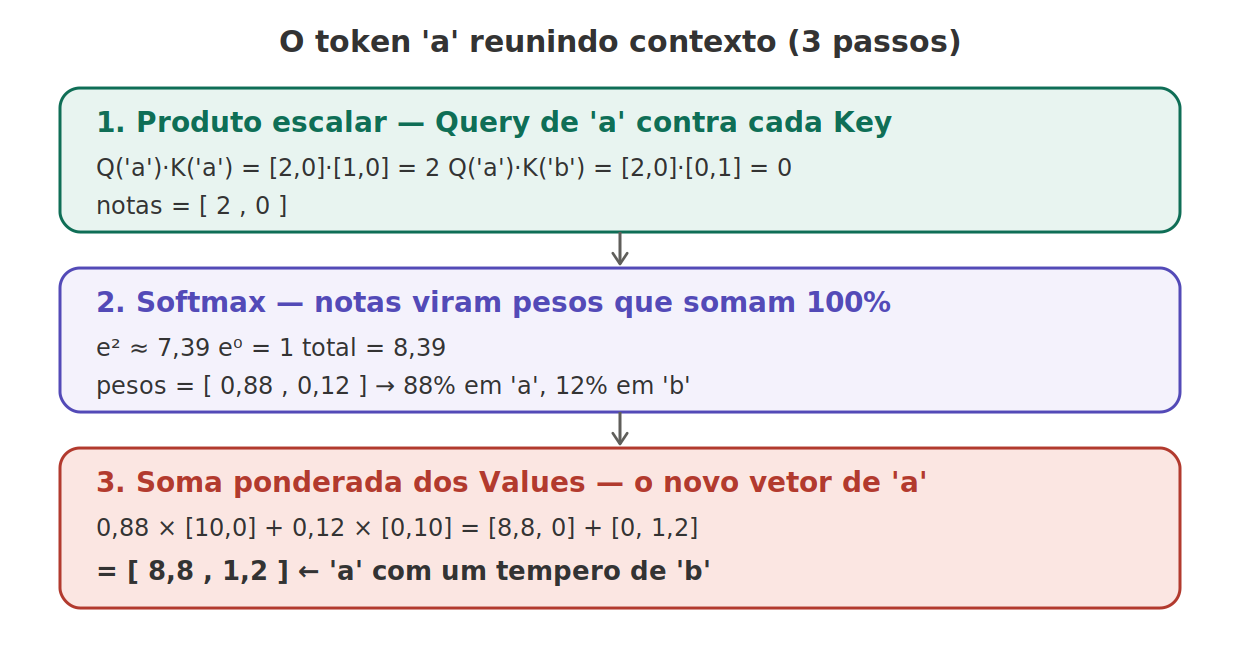
Passo 1 — "quanto casa?" (produto escalar). Comparamos o Query de 'a' com a
Key de cada token. O produto escalar multiplica posição por posição e soma:
'a' olhando 'a':  [2,0]·[1,0] = 2
'a' olhando 'b':  [2,0]·[0,1] = 0
notas de 'a' = [2, 0]
Até aqui, temos apenas notas — o quanto o pedido de
'a'casou com a etiqueta de cada token.
Passo 2 — virar pesos (softmax). As notas [2, 0] viram pesos que somam 100%.
O softmax faz e^nota para cada uma e divide pelo total:
e² ≈ 7,39    e⁰ = 1    total = 8,39
pesos = [7,39/8,39 , 1/8,39] ≈ [0,88 , 0,12]
Então 'a' presta 88% de atenção em si mesmo e 12% em 'b'.
Agora as notas viraram pesos que somam 100% — é onde o modelo decide em quem focar.
Passo 3 — misturar os Values. A nova versão de 'a' é a soma dos Values,
ponderada pelos pesos:
0,88 × [10,0] + 0,12 × [0,10] = [8,8, 0] + [0, 1,2] = [8,8, 1,2]
'a' saiu como [8,8, 1,2] — quase todo o conteúdo dele mesmo, com um tempero de
'b'. Ele reuniu contexto.
Agora usamos os pesos para misturar os Values — o token sai transformado, carregando um pouco dos vizinhos que importaram.
Detalhe técnico: na prática, antes do softmax, dividimos as notas por
√(tamanho do vetor)— um ajuste que estabiliza o treino. As "notas cruas" que entram no softmax têm um nome: logits.
A máscara causal (olhar só o passado)
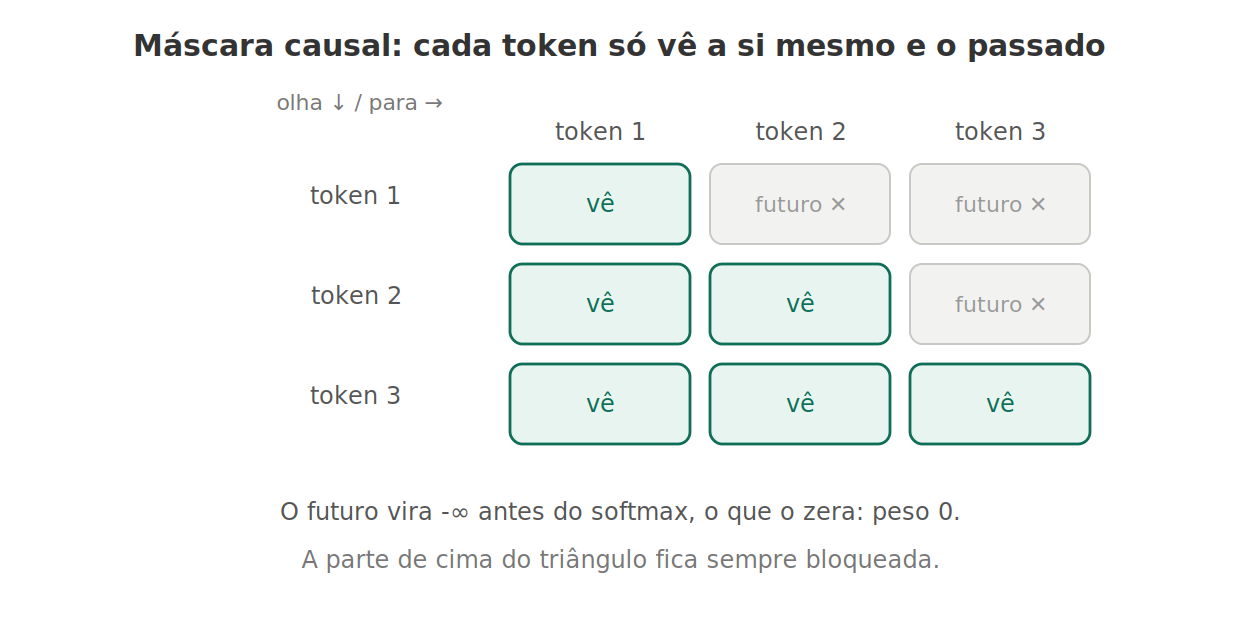
Nosso modelo gera texto um caractere por vez. Durante o treino, cada posição tem que prever o próximo caractere usando só o que veio até ela. Se um token pudesse ver o futuro, seria trapaça — ele copiaria a resposta.
A solução: antes do softmax, pegamos as posições "do futuro" e colocamos menos
infinito (-∞) nelas. Como o softmax faz e^nota, e e^(-∞) = 0, a posição
futura vira peso zero. Fazendo isso para todos os tokens, a grade de pesos vira
um triângulo.