18. O bloco e o modelo
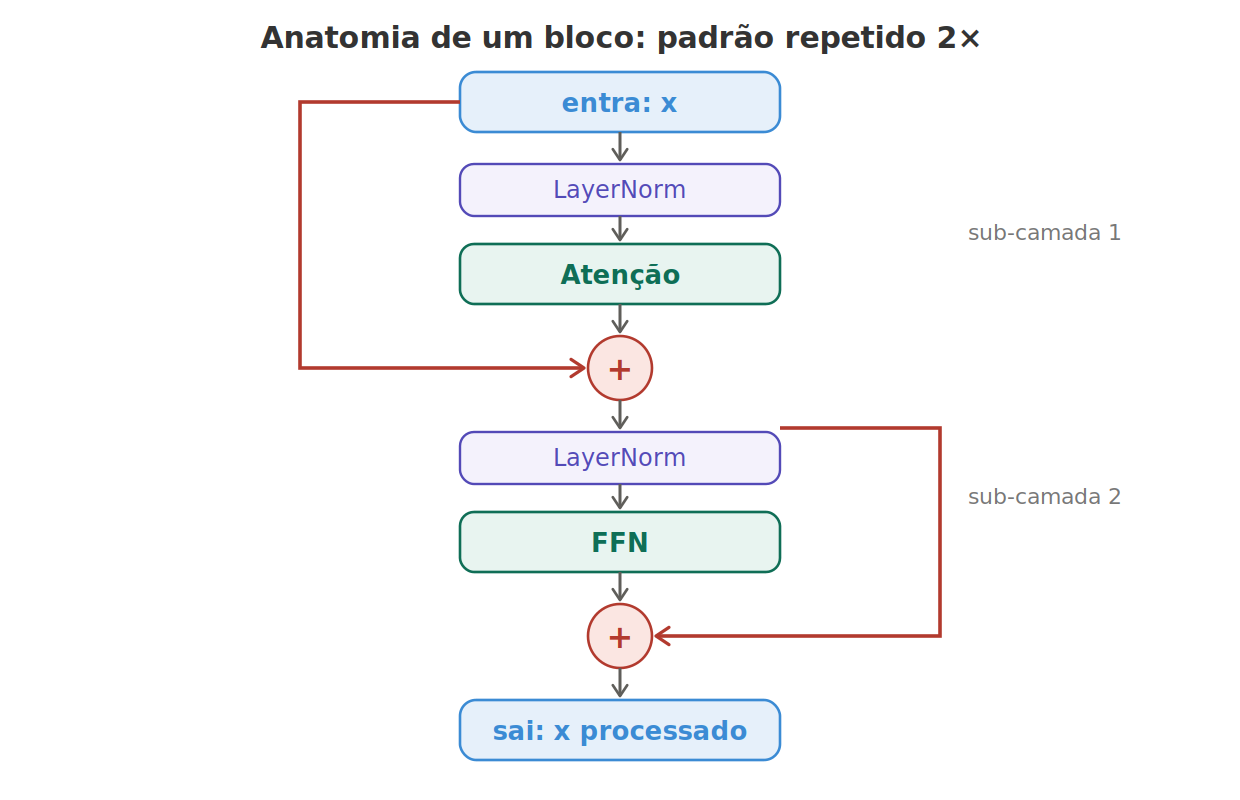
Um bloco junta atenção e FFN, cada uma embrulhada com LayerNorm e conexão residual. O padrão se repete duas vezes:
x = x + Atenção(LayerNorm(x))    # sub-camada 1
x = x + FFN(LayerNorm(x))        # sub-camada 2
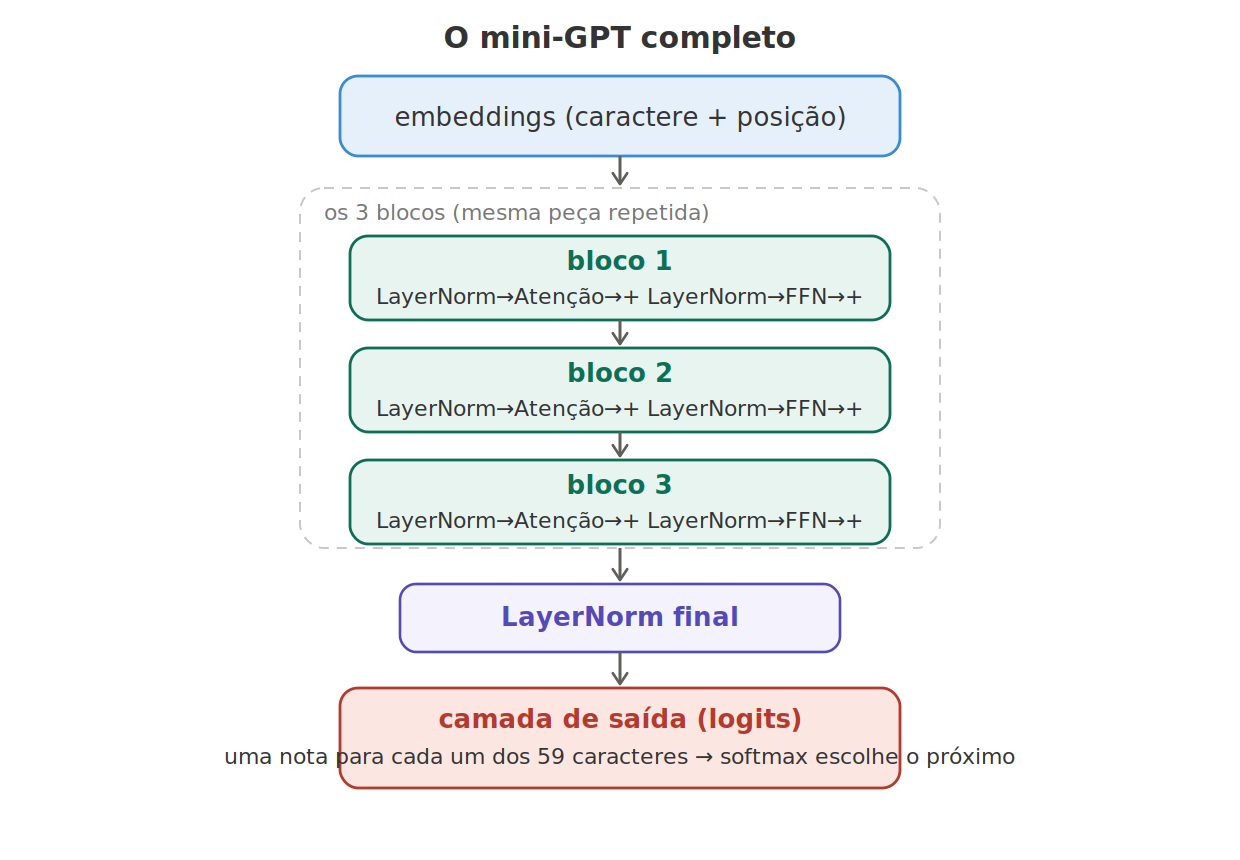
O modelo completo é: embeddings → alguns blocos empilhados → LayerNorm final → camada de saída (que dá uma nota para cada caractere).
O código do modelo
import torch
import torch.nn as nn
import torch.nn.functional as F

vocab_size = 59
n_embd     = 32
block_size = 32
n_layer    = 3

class Atencao(nn.Module):
    def __init__(self):
        super().__init__()
        self.query = nn.Linear(n_embd, n_embd, bias=False)
        self.chave = nn.Linear(n_embd, n_embd, bias=False)
        self.value = nn.Linear(n_embd, n_embd, bias=False)
        self.proj  = nn.Linear(n_embd, n_embd)
        self.register_buffer("mascara", torch.tril(torch.ones(block_size, block_size)))
    def forward(self, x):
        B, T, C = x.shape
        q, k, v = self.query(x), self.chave(x), self.value(x)
        notas = q @ k.transpose(-2, -1) / (C ** 0.5)
        notas = notas.masked_fill(self.mascara[:T, :T] == 0, float("-inf"))
        pesos = F.softmax(notas, dim=-1)
        return self.proj(pesos @ v)

class FFN(nn.Module):
    def __init__(self):
        super().__init__()
        self.rede = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd), nn.ReLU(), nn.Linear(4 * n_embd, n_embd),
        )
    def forward(self, x):
        return self.rede(x)

class Bloco(nn.Module):
    def __init__(self):
        super().__init__()
        self.ln1, self.atencao = nn.LayerNorm(n_embd), Atencao()
        self.ln2, self.ffn     = nn.LayerNorm(n_embd), FFN()
    def forward(self, x):
        x = x + self.atencao(self.ln1(x))
        x = x + self.ffn(self.ln2(x))
        return x

class MiniGPT(nn.Module):
    def __init__(self):
        super().__init__()
        self.emb_token   = nn.Embedding(vocab_size, n_embd)
        self.emb_posicao = nn.Embedding(block_size, n_embd)
        self.blocos      = nn.Sequential(*[Bloco() for _ in range(n_layer)])
        self.ln_final    = nn.LayerNorm(n_embd)
        self.saida       = nn.Linear(n_embd, vocab_size)
    def forward(self, idx):
        B, T = idx.shape
        tok = self.emb_token(idx)
        pos = self.emb_posicao(torch.arange(T, device=idx.device))
        x = tok + pos
        x = self.blocos(x)
        x = self.ln_final(x)
        return self.saida(x)
Repare como os 3 blocos viram uma linha: nn.Sequential(*[Bloco() for _ in range(n_layer)]).
Trocar o n_layer muda a profundidade do modelo. Esse modelo tem cerca de 42.700
parâmetros — minúsculo, de propósito, para caber num microcontrolador.
A frase-resumo:
"Cada bloco tem duas sub-camadas (atenção e FFN) na forma pre-norm:
x = x + SubCamada(LayerNorm(x)). O modelo é embeddings → blocos → LayerNorm final → camada linear de saída que produz os logits."