11. Embeddings: de número a vetor
O tokenizer nos deu números. Mas tem um problema: um número solto, como 33, é
pobre. Ele só serve de "crachá" do caractere — não dá para fazer contas úteis com
um crachá. É aqui que entra o embedding.
A ideia em uma frase: o embedding troca cada número por uma lista de números (um "vetor"), e essa lista é ajustada durante o treino.
A analogia: pense na diferença entre saber só o número de um funcionário (o crachá "33") e ter a ficha completa dele (uma lista de características: setor, tempo de casa, habilidades...). O número identifica; a ficha descreve. O embedding é a ficha: em vez de um número solto, cada caractere ganha uma lista de valores que capturam características dele.
Por que uma lista e não um número? Porque com vários números o modelo consegue guardar características do caractere: se é vogal, se costuma vir depois de espaço, se aparece em marcadores... Cada posição da lista é como uma "régua" medindo algum aspecto. Um número é um ponto; um vetor é uma descrição rica.
O exemplo concreto
Vamos usar um vocabulário de 3 caracteres (a, b, c) e vetores de tamanho 4.
A tabela de embeddings é uma grade com uma linha por caractere:
        col0    col1    col2    col3
linha 0:  0.5    -0.2     0.8     0.1     ← vetor do 'a'
linha 1: -0.7     0.3     0.4    -0.9     ← vetor do 'b'
linha 2:  0.2     0.6    -0.1     0.5     ← vetor do 'c'
Para pegar o embedding do 'c': o tokenizer diz que 'c' é o número 2, então
vamos na tabela e pegamos a linha 2. Simples assim — o número é o endereço da
linha, e a linha é o vetor.
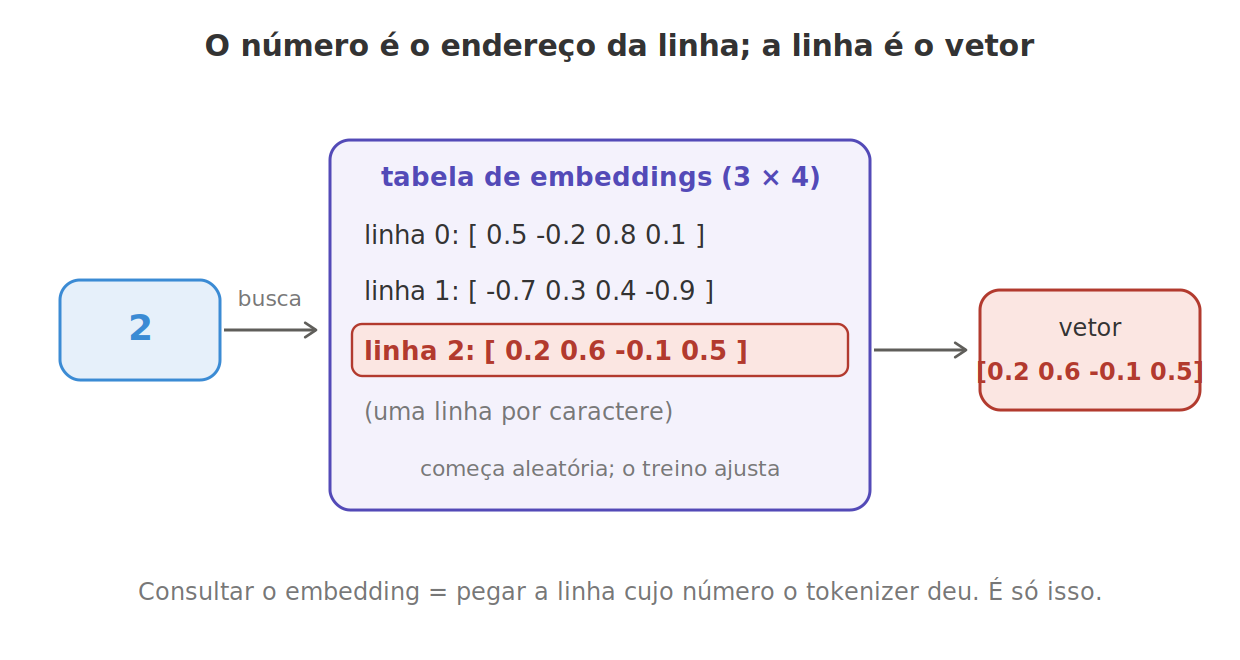
A parte mágica: aquela tabela começa preenchida com números aleatórios. Ela não sabe nada no início. Durante o treino, o modelo ajusta esses números para valores úteis, e caracteres parecidos acabam com vetores parecidos. Ou seja: o embedding é uma tabela de significados que o modelo preenche aprendendo.