10. O tokenizer
Aqui construímos a primeira peça do cérebro.
A ideia em uma frase: o tokenizer troca cada caractere por um número — porque o modelo só entende números, não letras.
A analogia: imagine um dicionário de mão dupla. De um lado, ele diz que 'a'
é o número 33. Do outro, que o número 33 é o 'a'. Com esse dicionário, você
traduz texto para números (para o modelo trabalhar) e números de volta para texto
(para você ler a resposta).
Por que caractere, e não palavra? Porque assim o "alfabeto" do modelo fica minúsculo: só as letras, espaço e pontuação que aparecem no dataset — no nosso caso, 59 símbolos. Um vocabulário pequeno é perfeito para um modelo que vai caber num microcontrolador.
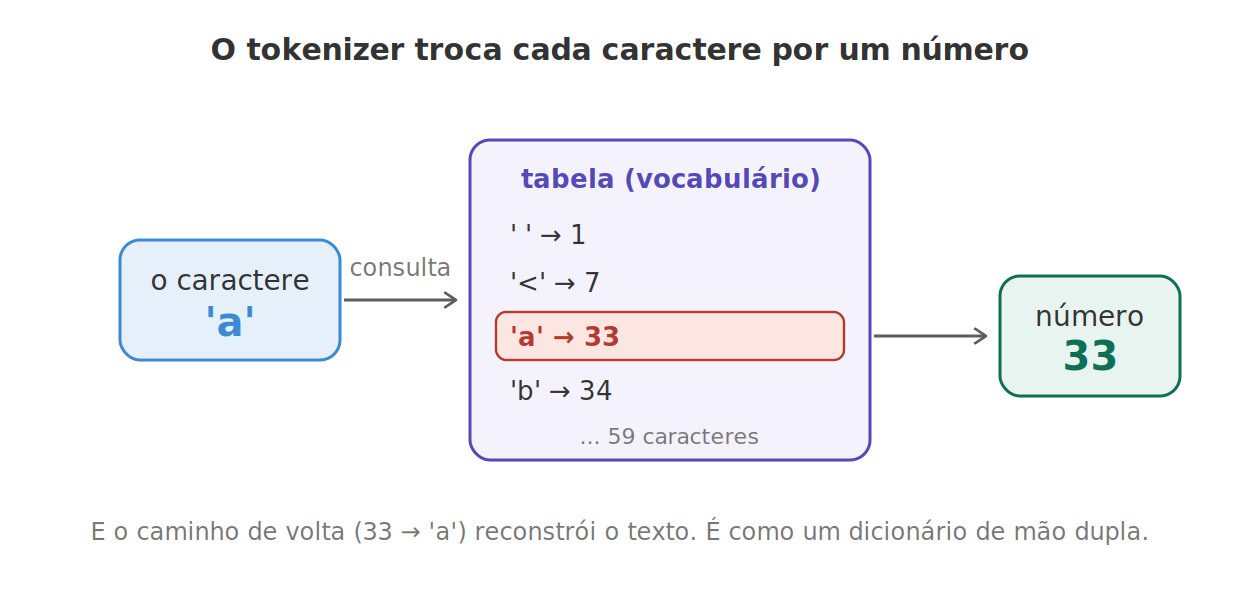
O exemplo concreto. Vamos fingir um vocabulário de 3 caracteres: a, b, c.
O tokenizer dá um número para cada:
a → 0 b → 1 c → 2
Então a palavra "cab" vira a lista de números [2, 0, 1]. E a lista [2, 0, 1]
volta a ser "cab". É uma tradução direta, sem mistério.
O código do tokenizer
Crie um arquivo tokenizer.py na pasta do projeto:
import json
from pathlib import Path

# 1. LER O DATASET
CAMINHO = Path(__file__).parent / "data" / "robot_voice.txt"
texto = CAMINHO.read_text(encoding="utf-8")

# 2. DESCOBRIR O ALFABETO (todos os caracteres únicos, em ordem)
caracteres = sorted(set(texto))
tamanho_vocab = len(caracteres)
print("Tamanho do vocabulário:", tamanho_vocab)

# 3. OS DOIS DICIONÁRIOS
stoi = {c: i for i, c in enumerate(caracteres)}   # caractere -> número
itos = {i: c for i, c in enumerate(caracteres)}   # número -> caractere

# 4. AS FUNÇÕES DE IDA E VOLTA
def encode(s):
    return [stoi[c] for c in s]          # texto  -> números

def decode(nums):
    return "".join(itos[n] for n in nums)  # números -> texto

# 5. TESTE DE IDA E VOLTA
frase = "<obstacle> Oh look, a wall."
numeros = encode(frase)
print("Números:", numeros)
print("Voltou:", decode(numeros))
print("Bateu igual?", frase == decode(numeros))

# 6. SALVAR O VOCABULÁRIO (as próximas etapas vão reusar)
with open(Path(__file__).parent / "vocab.json", "w", encoding="utf-8") as f:
    json.dump(caracteres, f, ensure_ascii=False)
Como funciona, em palavras simples:
sorted(set(texto))pega cada caractere único do dataset e coloca em ordem. Essa é a lista de "todos os símbolos que o modelo conhece" — o vocabulário.stoi(de string to int) é o dicionário caractere → número.itos(de int to string) é o caminho de volta, número → caractere.encodeusa ostoipara traduzir um texto em números;decodeusa oitospara o contrário.
Rodando
No terminal, dentro da pasta do projeto:
uv run python tokenizer.py
O que você deve ver:
Tamanho do vocabulário: 59
Números: [7, 47, 34, 51, 52, 33, 35, 44, 37, 8, 1, ...]
Voltou: <obstacle> Oh look, a wall.
Bateu igual? True
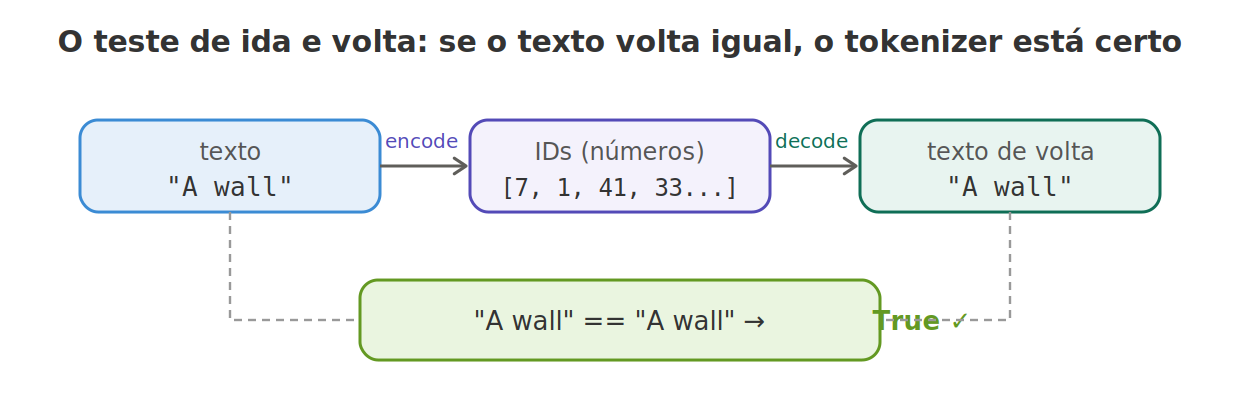
Aquele Bateu igual? True é o sinal de sucesso: o tokenizer traduziu para
números e voltou sem perder nada. Esse é o nosso primeiro teste isolado de peça —
a mesma regra de ouro do robô, agora no cérebro: se o texto não voltar idêntico, algo
está errado no tokenizer, e a gente conserta antes de seguir. E foi criado um arquivo vocab.json, que guarda
o alfabeto para as próximas etapas usarem exatamente o mesmo mapeamento.
A frase-resumo (para repetir com propriedade):
"Fiz tokenização em nível de caractere. O vocabulário tem 59 símbolos, e o tokenizer converte texto em números (encode) e de volta (decode) com um par de dicionários."
Fim da Instalação 1. Você já preparou o ambiente, criou o dataset com a personalidade do robô, e construiu a primeira peça do cérebro: o tokenizer. Na próxima instalação, vamos dar o segundo passo — os embeddings: como um número vira um "vetor de significado" que o modelo consegue processar.