19. Treino
O modelo recém-criado é um recém-nascido: pesos aleatórios, respostas sem sentido. O treino ajusta esses pesos. É um laço repetido milhares de vezes:
- Prever — o modelo tenta adivinhar o próximo caractere
- Medir o erro (o loss) — o quanto ele errou
- Calcular o gradiente — para onde empurrar cada peso
- Ajustar os pesos — um passinho na direção certa
- Repetir
O erro (loss)
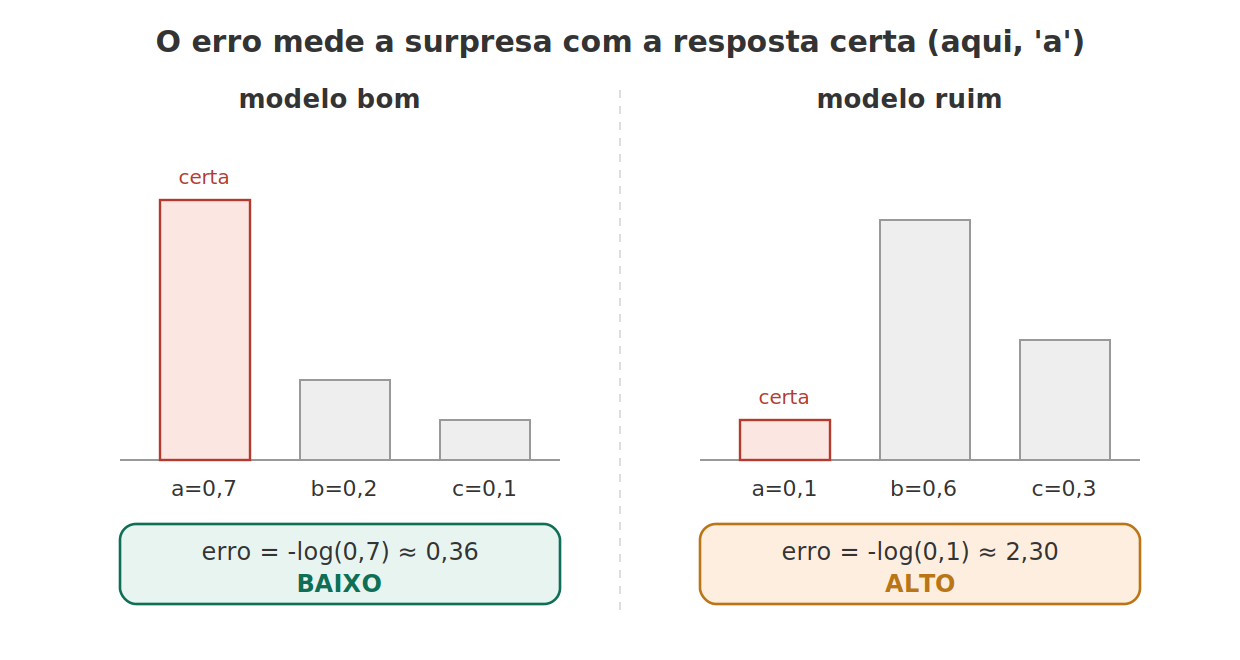
O modelo dá uma probabilidade para cada caractere. O erro mede a surpresa com
a resposta certa: probabilidade alta na resposta certa → erro baixo; probabilidade
baixa → erro alto. A fórmula (cross-entropy) é -log(prob da resposta certa).
O gradiente (a descida da montanha)
O gradiente diz, para cada peso, se aumentá-lo faz o erro subir ou descer. Andamos no sentido contrário (ladeira abaixo), com passo dado pela taxa de aprendizado. Repetindo, chegamos ao fundo do vale (menor erro).
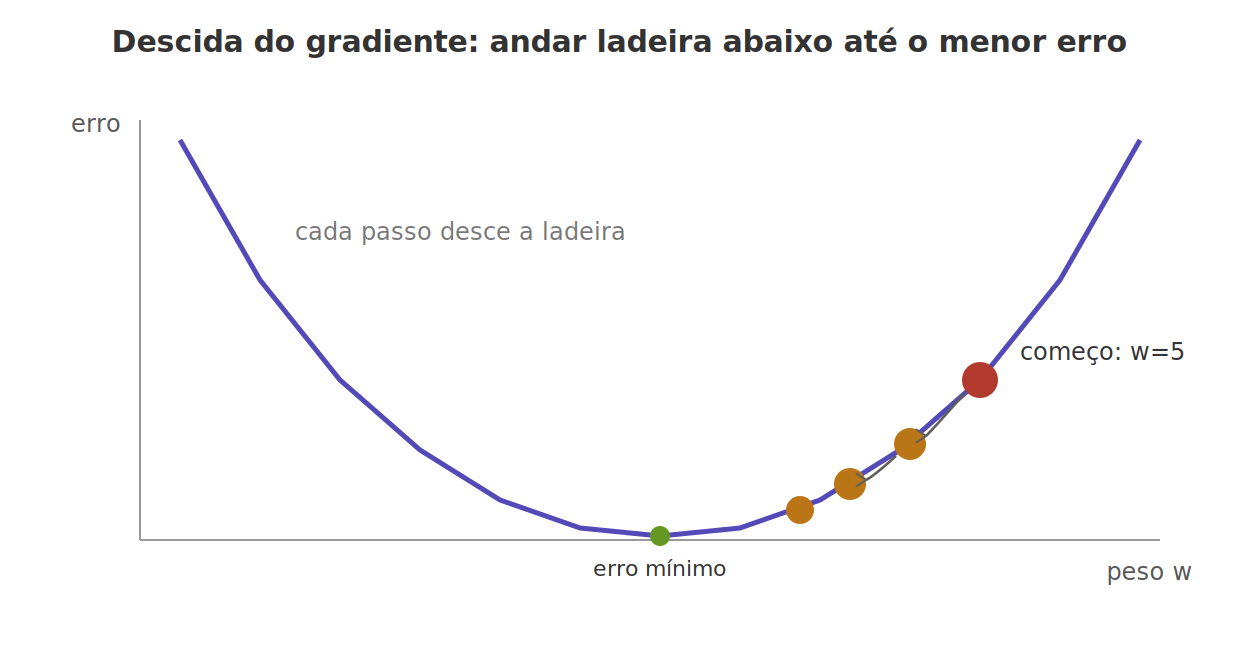
O PyTorch calcula os gradientes de todos os ~42.700 pesos automaticamente — isso se
chama backpropagation — com uma linha: loss.backward().
Como alimentamos o modelo
O modelo aprende prevendo o próximo caractere. Então a "resposta" é o texto
deslocado 1 posição. Para backup (janela de 5):
entrada (x):  b  a  c  k  u
resposta (y): a  c  k  u  p
O código do treino
import json
from pathlib import Path
import torch
import torch.nn.functional as F
from model import MiniGPT, block_size

batch_size, max_iters, lr = 32, 3000, 1e-3
device = "cuda" if torch.cuda.is_available() else "cpu"

pasta = Path(__file__).parent
caracteres = json.loads((pasta / "vocab.json").read_text(encoding="utf-8"))
stoi = {c: i for i, c in enumerate(caracteres)}
texto = (pasta / "data" / "robot_voice.txt").read_text(encoding="utf-8")
dados = torch.tensor([stoi[c] for c in texto], dtype=torch.long)

def pegar_lote():
    ini = torch.randint(len(dados) - block_size, (batch_size,))
    x = torch.stack([dados[i     : i + block_size]     for i in ini])
    y = torch.stack([dados[i + 1 : i + block_size + 1] for i in ini])
    return x.to(device), y.to(device)

modelo = MiniGPT().to(device)
otimizador = torch.optim.AdamW(modelo.parameters(), lr=lr)

for passo in range(max_iters + 1):
    x, y = pegar_lote()
    logits = modelo(x)                                  # prever
    B, T, V = logits.shape
    loss = F.cross_entropy(logits.view(B*T, V), y.view(B*T))  # erro
    otimizador.zero_grad()
    loss.backward()                                     # gradiente
    otimizador.step()                                   # ajustar
    if passo % 300 == 0:
        print(f"passo {passo:5d}  |  erro: {loss.item():.4f}")

torch.save(modelo.state_dict(), pasta / "modelo_treinado.pt")
O que você deve ver: o erro caindo de ~4,2 para menos de 1 ao longo dos passos, e
um arquivo modelo_treinado.pt salvo no fim. O AdamW é o otimizador — quem dá
o passo de descida.